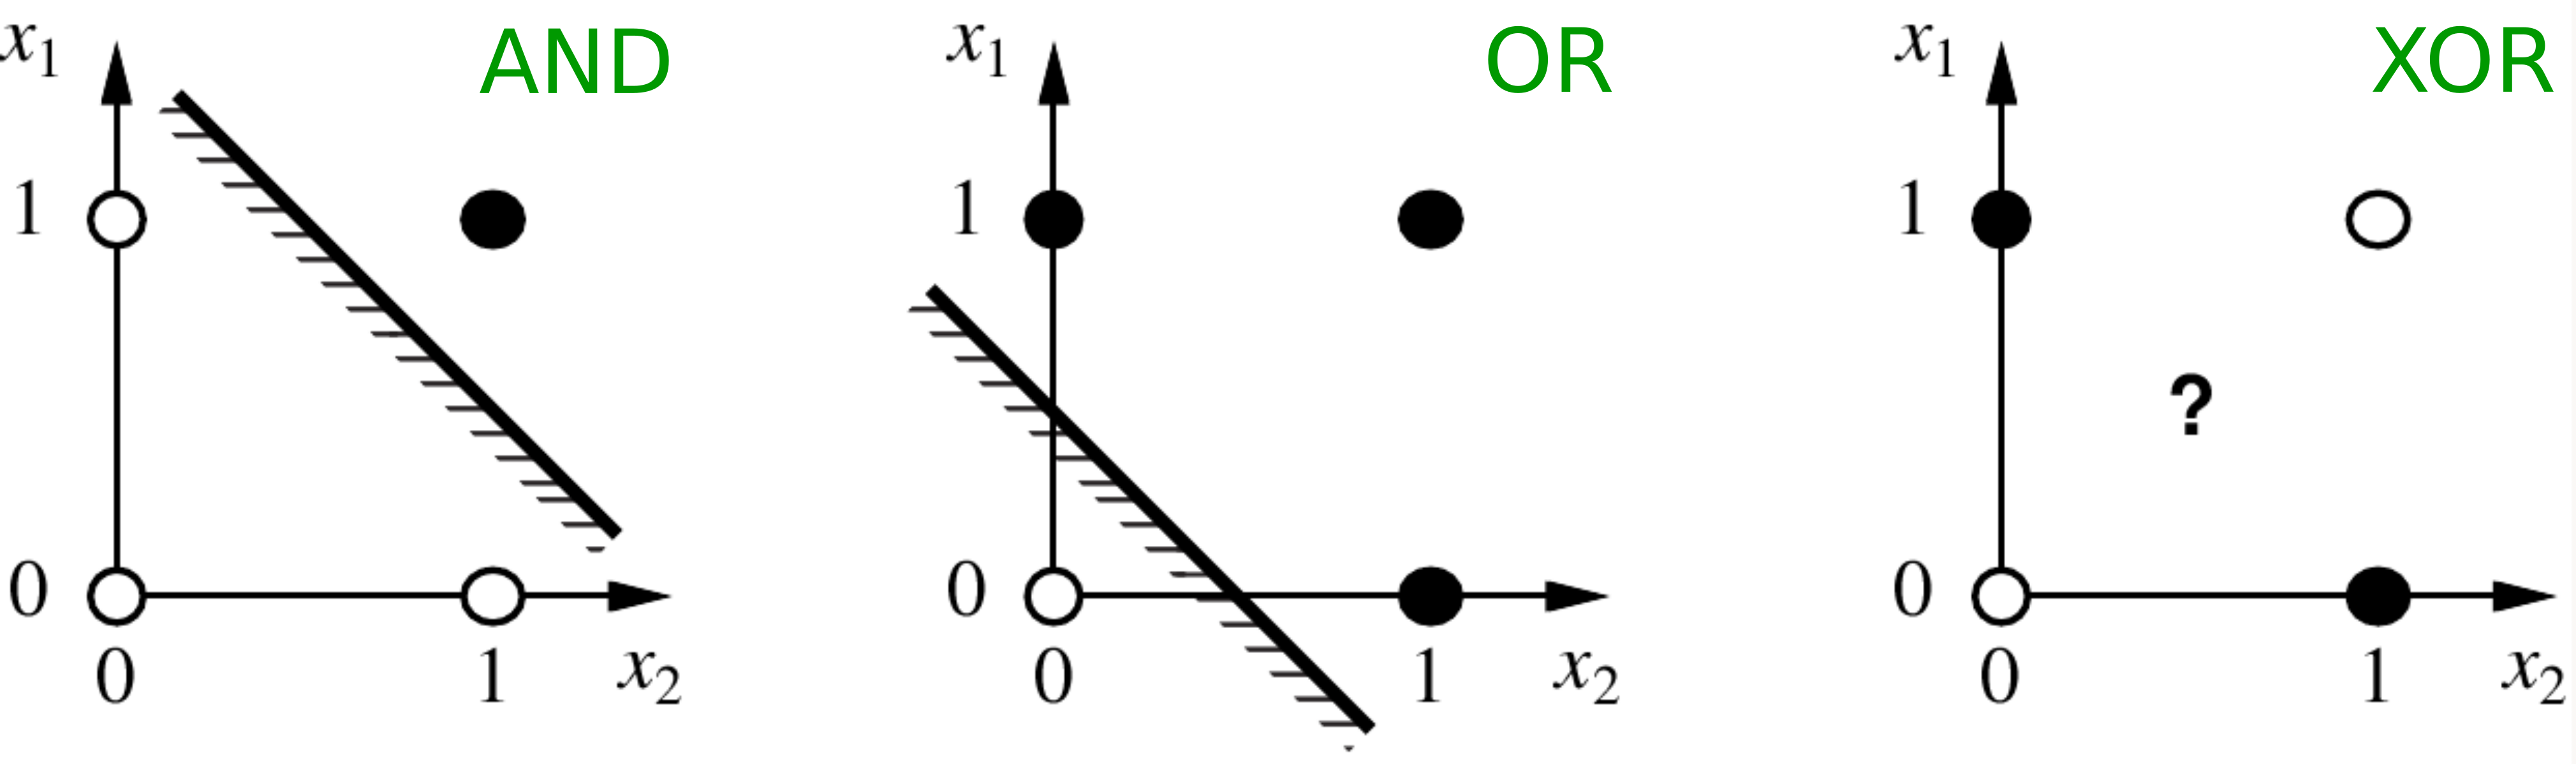
sign(output) must be correct
#!/usr/bin/env python3
import torch
import math
import matplotlib.pyplot as plt
#
# tanh layer
#
class MyLayer(torch.nn.Module): # inheritance
def __init__(self, dim1, dim2): # constructor
super().__init__()
self.weights = torch.randn(dim1,dim2,requires_grad=True)
self.bias = torch.randn(dim1,requires_grad=True)
def forward(self, x): # define forward pass
return torch.tanh(torch.matmul(self.weights,x)-self.bias)
def update(self, eps, nBatch): # updating weights / bias
with torch.no_grad():
self.weights -= eps*self.weights.grad / nBatch
self.bias -= eps*self.bias.grad / nBatch
self.weights.grad = None
self.bias.grad = None
#
# main
#
dimOutput = 1 # only 1 implemented
dimHidden = 2
dimInput = 2 # only 2 implemented
nBatch = 4 # only 4 implemented
nEpoch = 1000
learningRate = 4.0e-2
myLayerObject = MyLayer(dimHidden,dimInput) # instanstiation
myOutputObject = MyLayer(1,dimHidden)
# XOR for 2 inputs
booleanInput = torch.tensor([ [ 1.0, 1.0],
[ 1.0,-1.0],
[-1.0, 1.0],
[-1.0,-1.0] ])
booleanValue = torch.tensor([ [-1.0],
[ 1.0],
[ 1.0],
[-1.0] ])
print(booleanInput)
print(booleanValue)
#
# training loop
#
for iEpoch in range(nEpoch): # trainning loop
for iBatch in range(nBatch): # a batch for every epoch
#
thisInput = booleanInput[iBatch]
thisTarget = booleanValue[iBatch]
#
hidden = myLayerObject(thisInput) # forward pass (implicit)
output = myOutputObject(hidden)
loss = (output-thisTarget).pow(2).sum() # generic loss function
#--- alternative loss function
#--- ** just the sign has to be correct, may work only
#--- for some initial conditions (qualitatively)
# loss = torch.relu(0.75-output*thisTarget).pow(2).sum()
loss.backward() # adding gradients
if iEpoch>(nEpoch-9):
print(f'{thisInput.tolist()[0]:7.3f}' ,end="")
print(f'{thisInput.tolist()[1]:7.3f}' ,end="")
print(f'{thisTarget.tolist()[0]:7.3f} ||',end="")
print(f'{output.tolist()[0]:7.3f}')
if iBatch==(nBatch-1):
print()
#
myLayerObject.update(learningRate,nBatch) # gradients have
myOutputObject.update(learningRate,nBatch) # been summed up
# end of training
torch.linspace   nomen est omen
np.random.randint   random integers in range
#!/usr/bin/env python3
import torch
import math
import numpy as np
import matplotlib.pyplot as plt
#
# global variables
#
dimOutput = 1 # only 1 implemented
dimHidden = 40
dimInput = 1 # only 1 implemented
nData = 20 # number training pairs
nBatch = 20
nEpoch = 1000
learningRate = 4.0e-2
xMax = 3.0 # for data / plotting
#
# general layer
#
class MyLayer(torch.nn.Module): # inheritance
def __init__(self, dim1, dim2): # constructor
super().__init__()
self.weights = torch.zeros(dim1,dim2,requires_grad=True)
self.bias = torch.zeros(dim1, requires_grad=True)
mySigma = 1.0/math.sqrt(dim2) # scaling of weights
torch.nn.init.normal_(self.weights, mean=0.0, std=mySigma)
def forward(self, x): # tanh unit
return torch.tanh(torch.matmul(self.weights,x)-self.bias)
def forward_linear(self, x): # linear unit
return torch.matmul(self.weights,x) - self.bias
def update(self, eps):
with torch.no_grad():
self.weights -= eps*self.weights.grad
self.bias -= eps*self.bias.grad
self.weights.grad = None
self.bias.grad = None
#
# target: Bell curve and beyond
#
def target_curve(x):
return torch.exp(-0.5*x.pow(2)) / math.sqrt(2.0*math.pi)
# return torch.sin(x.pow(2)) + torch.cos(x)
#
# fixed training data
#
dataInput = torch.zeros((nData,dimInput))
dataInput[:,0] = torch.linspace(-xMax,xMax,nData)
dataValue = target_curve( dataInput[:,0] )
# print("\n# dataInput", dataInput.shape, "\n", dataInput)
# print("\n# dataValue", dataValue.shape, "\n", dataValue)
#
# instantiate model, define forward pass
#
layerHidden = MyLayer(dimHidden,dimInput)
layerOutput = MyLayer(dimOutput,dimHidden)
def modelForward(myInput):
hidden = layerHidden(myInput) # forward pass (implicit)
return layerOutput.forward_linear(hidden) # linear output units
#
# training loop
#
for iEpoch in range(nEpoch): # trainning loop
randIntArray = np.random.randint(nData,size=nBatch) # random sampling
# print("\n# randIntArray\n", randIntArray)
#
for iBatch in range(nBatch):
batchInput = dataInput[randIntArray[iBatch],:]
batchValue = dataValue[randIntArray[iBatch]]
output = modelForward(batchInput) # forward pass
trainingLoss = (output-batchValue).pow(2).sum()
trainingLoss.backward() # backward pass
layerHidden.update(learningRate/nBatch) # updating
layerOutput.update(learningRate/nBatch) # gradients
# print("# ", iIter, trainingLoss.tolist())
tenPercent = int(nEpoch/10)
if (iEpoch%tenPercent==0):
print(f'{iEpoch:7d} {trainingLoss:9.5f}')
#
# testing
#
nPlot = 100
xPlot = [-xMax + iPlot*2.0*xMax/nPlot for iPlot in range(nPlot)]
yPlot = [0.0 for _ in range(nPlot)]
zPlot = [0.0 for _ in range(nPlot)]
testInput = torch.zeros(dimInput)
for iPlot in range(nPlot):
testInput[0] = xPlot[iPlot]
testOutput = modelForward(testInput) # forward pass with test data
yPlot[iPlot] = target_curve( testInput[0] ).item()
zPlot[iPlot] = testOutput[0].item()
if (1==2):
for iPlot in range(nPlot):
print(xPlot[iPlot],yPlot[iPlot],zPlot[iPlot])
xPoints = [ dataInput[ii,0] for ii in range(nData)]
yPoints = [ dataValue[ii] for ii in range(nData)]
#
# plotting
#
plt.plot(xPlot, yPlot, 'k', label="data curve")
plt.plot(xPoints, yPoints, '.r', label="data points", markersize=8)
plt.plot(xPlot, zPlot, '--b', label="inference", linewidth=3.0)
plt.legend()
plt.xlabel('input activity')
plt.ylabel('output activity')
plt.savefig('foo.svg')
plt.show()
#!/usr/bin/env python3
import torch
import math
import numpy as np
import matplotlib.pyplot as plt
#
# global variables
#
dimOutput = 1 # only 1 implemented
dimHidden = 40
dimInput = 1 # only 1 implemented
nHidden = 2 # number of hidden layers
nData = 20 # number training pairs
nBatch = 20
nEpoch = 2000
learningRate = 4.0e-2 # eta
momemtum_mu = 0.8 # for momentum updating
xMax = 3.0 # for data / plotting
#
# general layer
#
class MyLayer(torch.nn.Module):
def __init__(self, dim1, dim2, mu=0.0):
super().__init__()
self.weights = torch.zeros(dim1,dim2,requires_grad=True)
self.bias = torch.zeros(dim1,requires_grad=True)
mySigma = 1.0/math.sqrt(dim2) # scaling of weights
torch.nn.init.normal_(self.weights, mean=0.0, std=mySigma)
self.weights_v = torch.zeros(dim1,dim2) # associated
self.bias_v = torch.zeros(dim1) # velocities
self.mu = mu # mometum update parameter [0,1]
def forward(self, x): # tanh unit
return torch.tanh(torch.matmul(self.weights,x)-self.bias)
def forward_linear(self, x): # linear unit
return torch.matmul(self.weights,x) - self.bias
def update(self, eps):
with torch.no_grad():
self.weights_v = self.mu*self.weights_v \
- eps*self.weights.grad # update
self.bias_v = self.mu*self.bias_v \
- eps*self.bias.grad # velocities
self.weights += self.weights_v
self.bias += self.bias_v
self.weights.grad = None
self.bias.grad = None
#
# target: Bell curve and beyond
#
def target_curve(x):
# return torch.exp(-0.5*x.pow(2)) / math.sqrt(2.0*math.pi)
return torch.sin(x.pow(2)) + torch.cos(x)
#
# fixed training data
#
dataInput = torch.zeros((nData,dimInput))
dataInput[:,0] = torch.linspace(-xMax,xMax,nData)
dataValue = target_curve( dataInput[:,0] )
# print("\n# dataInput\n", dataInput)
# print("\n# dataValue\n", dataValue)
#
# instantiate model, define forward pass
#
allHidden = [None for iH in range(nHidden)]
allHidden[0] = MyLayer(dimHidden,dimInput,momemtum_mu)
for iH in range(1,nHidden):
allHidden[iH] = MyLayer(dimHidden,dimHidden,momemtum_mu)
layerOutput = MyLayer(dimOutput,dimHidden,momemtum_mu)
def modelForward(myInput):
hidden = allHidden[0](myInput) # input -> first hidden
for iH in range(1,nHidden):
hidden = allHidden[iH](hidden)
return layerOutput.forward_linear(hidden) # linear output units
#
# training loop
#
for iEpoch in range(nEpoch): # trainning loop
randIntArray = np.random.randint(nData, size=nBatch)
# print("\n# randIntArray\n", randIntArray)
for iBatch in range(nBatch):
batchInput = dataInput[randIntArray[iBatch],:]
batchValue = dataValue[randIntArray[iBatch]]
output = modelForward(batchInput) # forward pass
trainingLoss = (output-batchValue).pow(2).sum()
trainingLoss.backward() # backward pass
for iH in range(nHidden):
allHidden[iH].update(learningRate/nBatch)
layerOutput.update(learningRate/nBatch)
if (iEpoch%int(nEpoch/20)==0):
print(f'{iEpoch:7d} {trainingLoss:9.5f}')
#
# testing
#
nPlot = 100
xPlot = [-xMax + iPlot*2.0*xMax/nPlot for iPlot in range(nPlot)]
yPlot = [0.0 for _ in range(nPlot)]
zPlot = [0.0 for _ in range(nPlot)]
testInput = torch.zeros(dimInput)
for iPlot in range(nPlot):
testInput[0] = xPlot[iPlot]
testOutput = modelForward(testInput) # forward pass with test data
yPlot[iPlot] = target_curve( testInput[0] ).item()
zPlot[iPlot] = testOutput[0].item()
if (1==2):
for iPlot in range(nPlot):
print(xPlot[iPlot],yPlot[iPlot],zPlot[iPlot])
xPoints = [ dataInput[ii,0] for ii in range(nData)]
yPoints = [ dataValue[ii] for ii in range(nData)]
#
# plotting
#
plt.plot(xPlot, yPlot, 'k', label="data curve")
plt.plot(xPoints, yPoints, '.r', label="data points", markersize=8)
plt.plot(xPlot, zPlot, '--b', label="inference", linewidth=3.0)
plt.legend()
plt.xlabel('input activity')
plt.ylabel('output activity')
plt.savefig('foo.svg')
plt.show()
self.weights =
torch.nn.Parameter(torch.zeros(dim1,dim2))optimOut = torch.optim.Adam(layerOut.parameters(),
lr=learningRate)optimOut.step()optimOut.zero_grad()update() routine in layer module
#!/usr/bin/env python3
import torch
import math
import numpy as np
import matplotlib.pyplot as plt
#
# global variables
#
dimOutput = 1 # only 1 implemented
dimHidden = 40
dimInput = 1 # only 1 implemented
nHidden = 2 # at least one
nData = 20 # number training pairs
nBatch = 20
nEpoch = 1000
learningRate = 1.0e-3 # eta
xMax = 3.0 # for data / plotting
#
# general layer
#
class MyLayer(torch.nn.Module):
def __init__(self, dim1, dim2):
super().__init__()
self.weights = torch.nn.Parameter(torch.zeros(dim1,dim2))
self.bias = torch.nn.Parameter(torch.zeros(dim1)) # to be adapted
mySigma = 1.0/math.sqrt(dim2) # scaling of weights
torch.nn.init.normal_(self.weights, mean=0.0, std=mySigma)
def forward(self, x): # tanh unit
return torch.tanh(torch.matmul(self.weights,x)-self.bias)
def forward_linear(self, x): # linear unit
return torch.matmul(self.weights,x) - self.bias
#
# target: Bell curve and beyond
#
def target_curve(x):
# return torch.exp(-0.5*x.pow(2)) / math.sqrt(2.0*math.pi)
return torch.sin(x.pow(2)) + torch.cos(x)
#
# fixed training data
#
dataInput = torch.zeros((nData,dimInput))
dataInput[:,0] = torch.linspace(-xMax,xMax,nData)
dataValue = target_curve( dataInput[:,0] )
#
# instantiate model
#
allHidden = [None for iH in range(nHidden)]
allHidden[0] = MyLayer(dimHidden,dimInput)
for iH in range(1,nHidden):
allHidden[iH] = MyLayer(dimHidden,dimHidden)
layerOut = MyLayer(dimOutput,dimHidden)
#
# instantiate optimizer
# SGD: stochastic gradient descent
#
allOptim = [None for iH in range(nHidden)]
for iH in range(nHidden):
allOptim[iH] = torch.optim.SGD(allHidden[iH].parameters(),
lr=learningRate,momentum=0.7)
optimOut = torch.optim.Adam(layerOut.parameters(),lr=learningRate)
#
# define forward pass
#
def modelForward(myInput):
hidden = allHidden[0](myInput)
for iH in range(1,nHidden):
hidden = allHidden[iH](hidden)
return layerOut.forward_linear(hidden)
#
# training loop
#
for iEpoch in range(nEpoch): # trainning loop
randIntArray = np.random.randint(nData, size=nBatch)
for iBatch in range(nBatch):
batchInput = dataInput[randIntArray[iBatch],:]
batchValue = dataValue[randIntArray[iBatch]]
output = modelForward(batchInput) # forward pass
trainingLoss = (output-batchValue).pow(2).sum()
trainingLoss.backward() # backward pass
for iH in range(nHidden):
allOptim[iH].step() # adapting parameters
allOptim[iH].zero_grad() # zero gradients
optimOut.step()
optimOut.zero_grad()
if (iEpoch%int(nEpoch/20)==0):
print(f'{iEpoch:7d} {trainingLoss:9.5f}')
#
# testing
#
nPlot = 100
xPlot = [-xMax + iPlot*2.0*xMax/nPlot for iPlot in range(nPlot)]
yPlot = [0.0 for _ in range(nPlot)]
zPlot = [0.0 for _ in range(nPlot)]
testInput = torch.zeros(dimInput)
for iPlot in range(nPlot):
testInput[0] = xPlot[iPlot]
testOutput = modelForward(testInput) # forward pass with test data
yPlot[iPlot] = target_curve( testInput[0] ).item()
zPlot[iPlot] = testOutput[0].item()
if (1==2):
for iPlot in range(nPlot):
print(xPlot[iPlot],yPlot[iPlot],zPlot[iPlot])
xPoints = [ dataInput[ii,0] for ii in range(nData)]
yPoints = [ dataValue[ii] for ii in range(nData)]
#
# plotting
#
plt.plot(xPlot, yPlot, 'k', label="data curve")
plt.plot(xPoints, yPoints, '.r', label="data points", markersize=8)
plt.plot(xPlot, zPlot, '--b', label="inference", linewidth=3.0)
plt.legend()
plt.xlabel('input activity')
plt.ylabel('output activity')
plt.savefig('foo.svg')
plt.show()
#!/usr/bin/env python3
import numpy as np
import matplotlib.pyplot as plt
x = np.linspace(-6, 6, 1000)
def sigmoid(x):
return 1 / (1 + np.exp(-x))
def silu(x):
return x * sigmoid(x)
def gelu(x): # standard approximation
return 0.5 * x * (1 + np.tanh(np.sqrt(2/np.pi) * (x + 0.044715 * x**3)))
def sigmoid_prime(x):
s = sigmoid(x)
return s * (1 - s)
def silu_prime(x):
s = sigmoid(x)
return s * (1 + x * (1 - s))
def gelu_prime(x):
# numerical derivative for the tanh-approx GELU
h = 1e-5
return (gelu(x + h) - gelu(x - h)) / (2 * h)
fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))
# --- Left: the activations themselves ---
axes[0].plot(x, sigmoid(x), label=r'$\sigma(x)$ (sigmoid)', lw=2)
axes[0].plot(x, silu(x), label=r'SiLU$(x)$', lw=2)
axes[0].plot(x, gelu(x), label=r'GELU$(x)$', lw=2)
axes[0].axhline(0, color='k', lw=0.5)
axes[0].axvline(0, color='k', lw=0.5)
axes[0].set_title('Activations')
axes[0].set_xlabel('x')
axes[0].legend()
axes[0].grid(alpha=0.3)
# --- Right: the derivatives (gradient flow) ---
axes[1].plot(x, sigmoid_prime(x), label=r"$\sigma'(x)$", lw=2)
axes[1].plot(x, silu_prime(x), label=r"SiLU'$(x)$", lw=2)
axes[1].plot(x, gelu_prime(x), label=r"GELU'$(x)$", lw=2)
axes[1].axhline(0, color='k', lw=0.5)
axes[1].axvline(0, color='k', lw=0.5)
axes[1].set_title('Derivatives (gradient magnitude)')
axes[1].set_xlabel('x')
axes[1].legend()
axes[1].grid(alpha=0.3)
plt.tight_layout()
plt.savefig('activation_compare.png', dpi=150)
plt.show()
torch.gelu() self-gated
transfer function [:dim/2 ] $\,\to\,x_{\rm linear}$ [ dim/2:] $\,\to\,x_{\rm gate}$
#!/usr/bin/env python3
import torch
import torch.nn as nn
import torch.nn.functional as F
class GeGLU(nn.Module):
def __init__(self, dim, d_large):
super().__init__()
# We project to 2 * d_large so we can chunk it in half later
self.w12 = nn.Linear(dim, 2 * d_large, bias=False)
self.w3 = nn.Linear(d_large, dim, bias=False)
def forward(self, x):
# projecting to double size
projected = self.w12(x)
# chunking in half
x_linear, x_gate = projected.chunk(2, dim=-1)
# gating and down-projecting
return self.w3(x_linear * F.gelu(x_gate))
# Example usage:
# Batch size=2, Sequence length=4, Embedding dim=128
x = torch.randn(2, 4, 128)
layer = GeGLU(dim=128, d_large=512)
output = layer(x)
print(output.shape) # torch.Size([2, 4, 128])